Dies ist der erste Artikel unserer Reihe XasCode. Hier wollen wir zeigen, warum und wie wir Docs-as-Code in unserem Forschungsprojekt einsetzen – und das nur mit Open-Source-Tools.
Warum Docs-as-Code?
Immer, wenn mehrere Entwickler gemeinsam an einem Projekt arbeiten, ist der Informationsaustausch für den Erfolg des Vorhabens essenziell. Während Meetings und Einzelgespräche für die Koordination untereinander ausreichend sein mögen, muss gemeinsames Wissen auch langfristig für alle zugänglich gespeichert werden. Ob persönliche Notizen, Miro-Boards, Confluence-Seiten oder Chatverläufe: Jede*r Mitwirkende ist normalerweise dazu angehalten, sich am Aufbau eines gemeinsamen Schwarmgedächtnisses zu beteiligen. Die vielfältigen Möglichkeiten zur Persistierung von Dokumentation sind schier unendlich, doch diese individuelle Freiheit birgt das Risiko, dass sich im Laufe der Zeit zahlreiche getrennte Speicherorte im Projekt etablieren. Diese können je nach Motivation der jeweiligen Mitwirkenden unterschiedliche Detailgrade erreichen. Natürlich werden vorher in den meisten Fällen gemeinsame Ablageorte, Formate und Standards für die Dokumentation festgelegt. Aber wer kontrolliert verlässlich und dauerhaft die Einhaltung dieser Absprachen? Wie können wir sicherstellen, dass sich das, was in der Dokumentation behauptet wird, auch in deren Implementierung widerspiegelt? Sind wir sicher, dass Dokumentation und Code nicht auf lange Sicht auseinanderdriften?
Diese Fragen haben wir uns auch zu Beginn unseres Forschungsprojektes GENIUS gestellt. Die zusätzliche Randbedingung war, dass die Antwort im Open-Source-Raum zu finden ist.
Unser Open-Source-Docs-as-Code-Stack
Warum Open Source?
Im Rahmen unseres Forschungsprojekts wollen wir unseren Werkzeugkasten möglichst unabhängig und wirtschaftlich aufbauen, unter anderem auch zum Schutz von Kundendaten. Außerdem haben wir uns – ganz im Sinne der digitalen Souveränität – für kostenlose und leichtgewichtige Lösungen entschieden, die alle selbst gehostet werden. Mit den von uns verwendeten Tools erstellen wir uns damit ohne großen Aufwand eine abgespeckte Variante kostenpflichtiger Dienste wie Confluence, die sich sowohl für professionelle als auch für Hobbyprojekte eignet.
Was Docs-as-Code uns bringt
Der Kern des Ansatzes ist schnell erklärt: Wir behandeln Dokumentation wie Quellcode. Sie liegt als Klartext im selben Repository wie die Implementierung, die sie beschreibt, und durchläuft dieselben Prozesse. Was zunächst nach einer reinen Ablage-Entscheidung aussieht, ändert erstaunlich viel.
Zuerst wird Dokumentation versionierbar. Jede Änderung hat einen Autor bzw. eine Autorin, einen Zeitpunkt und im besten Fall eine Commit-Nachricht, die erklärt, warum sie nötig war. So können wir nachvollziehen, wie ein Konzept über Monate gewachsen ist, und bei Bedarf zu einem älteren Stand zurückkehren. Weil Doku und Code im selben Branch liegen, gehört zu jedem Feature-Zweig auch der passende Dokumentationsstand: Ein Release-Tag beschreibt nicht das, was wir uns für die Zukunft vorgenommen haben, sondern das, was zu diesem Zeitpunkt tatsächlich existierte.
Dann wird sie reviewbar. Eine Änderung an der Architekturdokumentation kommt als Merge Request, genau wie eine Änderung am Code, und bekommt damit das zweite Paar Augen. Wer eine Schnittstelle umbaut, ohne die zugehörige Beschreibung anzufassen, muss sich diese Frage im Review gefallen lassen. Das ist zwar keine Garantie gegen das eingangs beschriebene Auseinanderdriften, aber immerhin ein Ort, an dem es auffällt.
Und schließlich wird sie automatisierbar. Was in der Versionsverwaltung liegt, kann eine Pipeline anfassen: bauen, veröffentlichen, auf tote Links prüfen, gegen Stilregeln linten. Die fertige Website entsteht dann nicht, weil jemand daran gedacht hat, sie zu aktualisieren, sondern weil jemand etwas gepusht hat. Wie das bei uns konkret aussieht, zeigen wir weiter unten.
Welcher Code as Docs?
Der erste Schritt dahin ist die Festlegung auf eine gemeinsame Sprache. Neben der natürlichen Sprache, die wir für technische Dokumentation grundsätzlich auf Englisch festlegen, beinhaltet das auch die Entscheidung für eine gemeinsame Markup-Sprache. Es stehen sehr viele zur Auswahl, die je nach Projekt-Ökosystem mehr oder weniger populär sind. Obwohl im Python-Kontext, zu dem auch unser Forschungsprojekt gehört, häufig RestructuredText oder Markdown zum Einsatz kommen, haben wir uns für dieses Projekt für AsciiDoc entschieden, da es unter den besonders dokumentationsfreudigen Pentacornesen fast wie eine zweite Muttersprache ist. Mithilfe der feature-reichen AsciiDoctor-Suite steht uns mit dieser Wahl eine solide Grundlage für die Generierung von Dokumentation in verschiedenen Ausgabeformaten zur Verfügung. Damit werden einfache Textdateien mit der Endung .adoc direkt in der Versionsverwaltung zur Single Source of Truth für den Informationsaustausch.
Von Textdateien zur fertigen Dokumentation
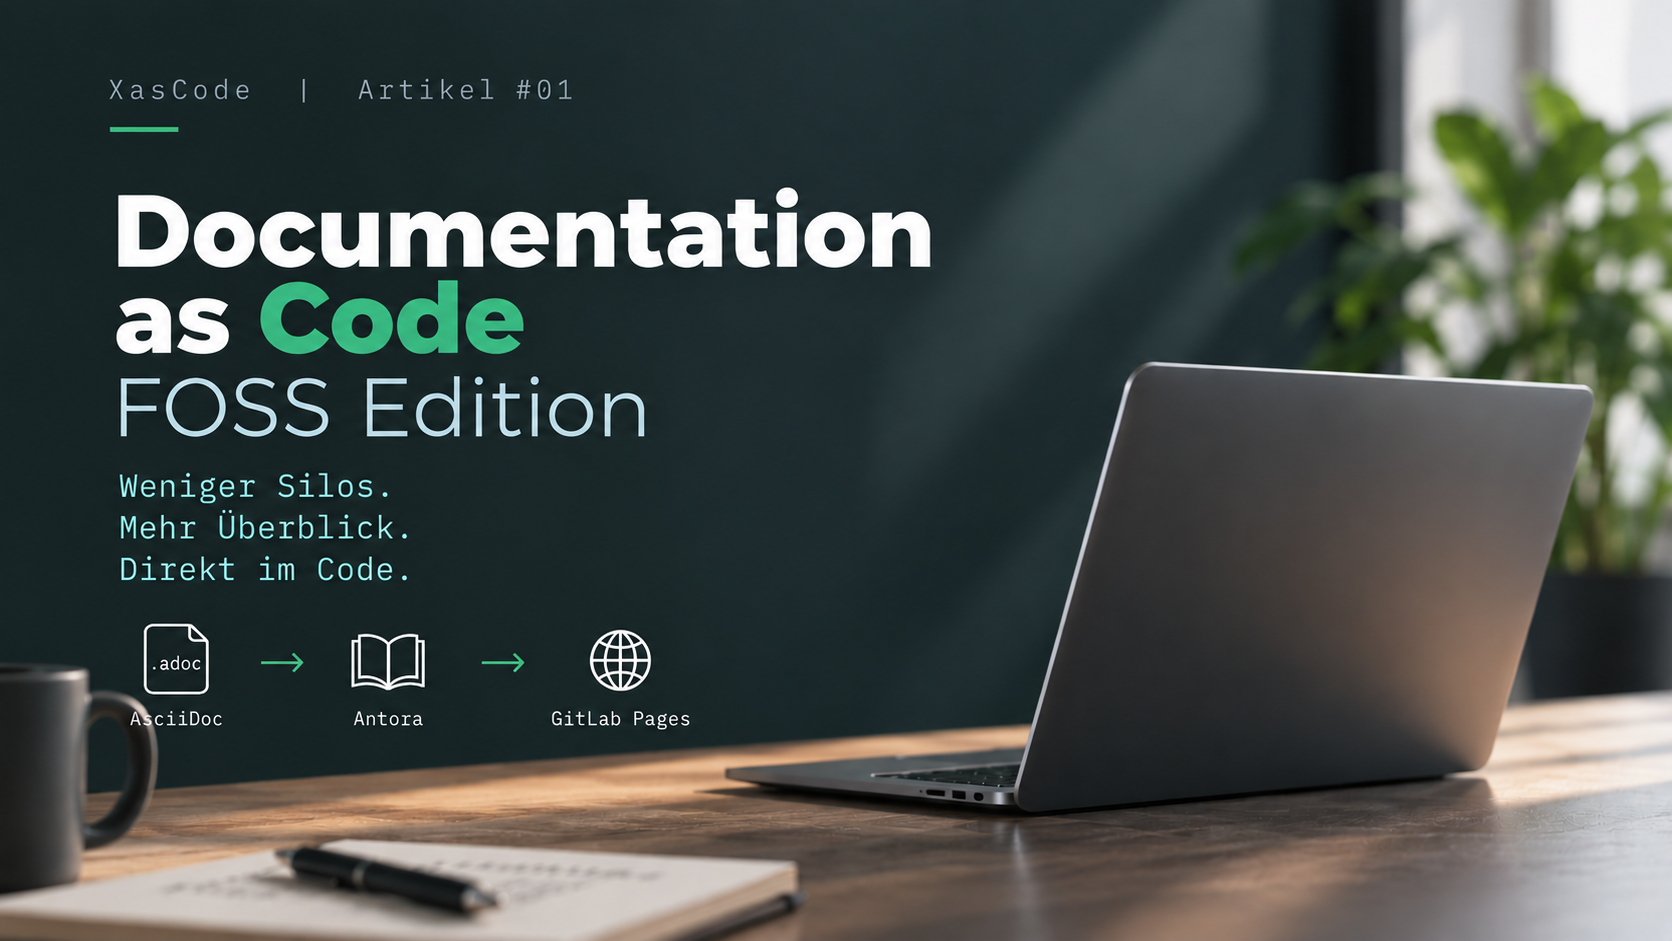
Der Weg von unseren Textdateien zur fertigen Website, über die wir eine schön formatierte, versionierte Dokumentation abrufen können, ist natürlich lang. Glücklicherweise gibt es in unserem OpenSource-Werkzeuggürtel ein paar Abkürzungen dafür. Wenn wir uns die Dokumentation von AsciiDoc anschauen, stellen wir fest, dass für deren Generierung das Antora-Framework verwendet wird. Dieses kann auch für unser Projekt statische HTML-Seiten mit konfigurierbarem Design aus der Dokumentation aus (bei Bedarf mehreren) Git-Repositories erstellen. Da eine unserer Projektpartnerinnen uns für das Forschungsprojekt eine GitLab-Instanz zur Verfügung stellt, nutzen wir direkt GitLab-Pages für das Hosting der von Antora generierten statischen Website. Damit können wir sehr einfach eine Pipeline definieren, die uns die Dokumentation erstellt und veröffentlicht.
pages:
  stage: deploy
  rules:
    - if: '$CI_PIPELINE_SOURCE == "push"'
      changes:
        - docs/**/*
        - antora-playbook.yml
        - .gitlab-ci.yml
    - when: never
  interruptible: true
  script:
    - antora generate --fetch --redirect-facility=gitlab --to-dir=public antora-playbook.yml
  artifacts:
    paths:
      - public
.gitlab-ci.yml (Auszug)
Bonus: Diagrams-as-Code mit oder ohne Kroki
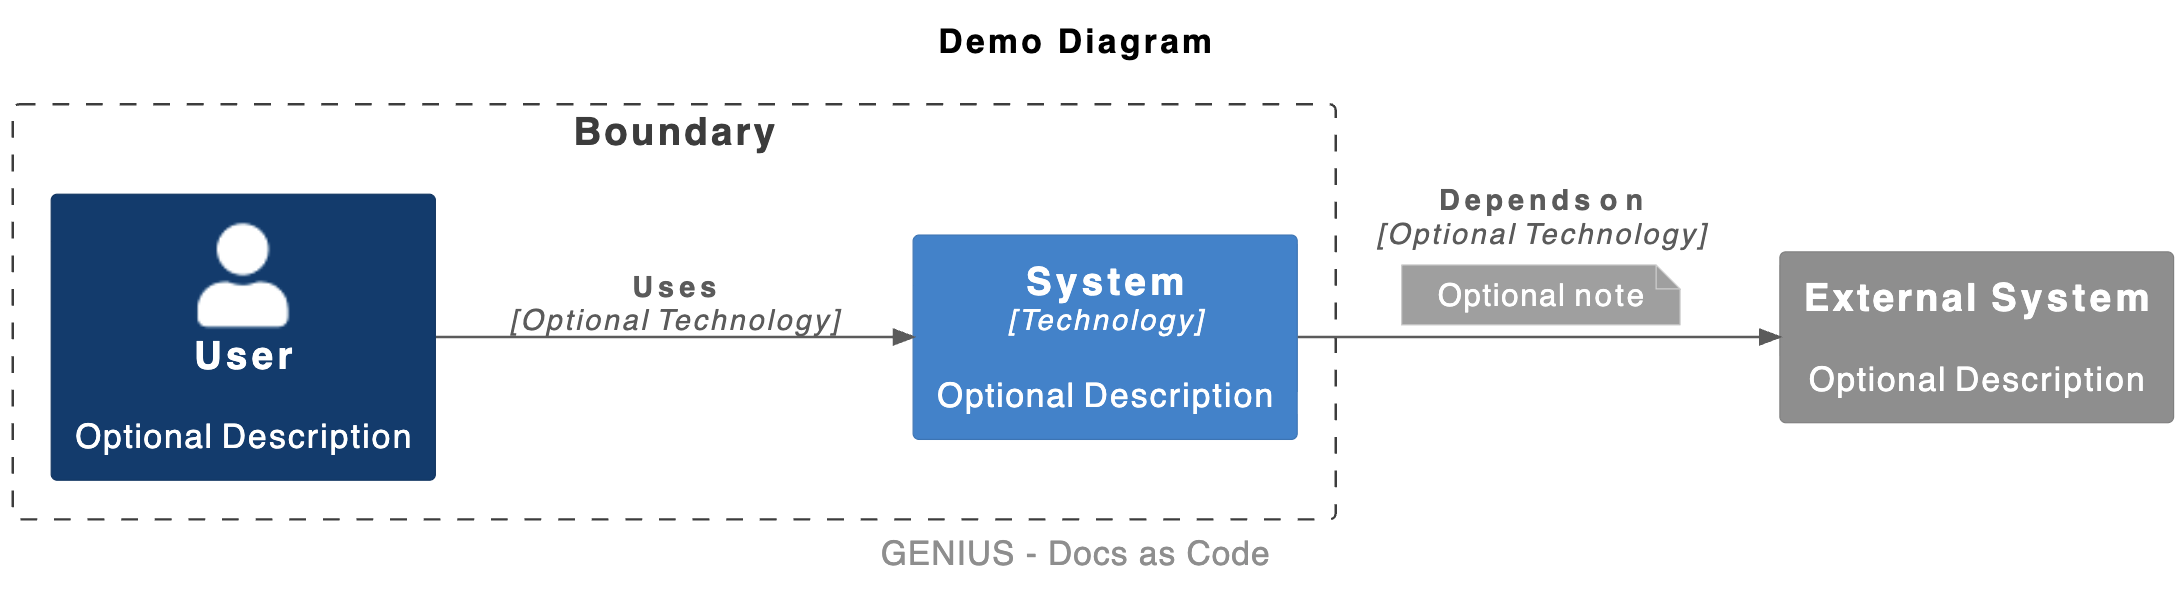
Was an dieser Stelle noch erwähnenswert ist, aber aufgrund der eher kleinen Rolle im Gesamtprojekt keinen eigenen Artikel bekommt, ist Diagrams-as-Code. Ein sehr nützlicher Dienst ist hier Kroki, den es sowohl als Web-API als auch im Docker-Container gibt. Kroki spricht die gängigsten Diagrammsprachen und erzeugt aus Textdateien (je nach investiertem Aufwand) oft wunderschöne SVGs, die wir direkt in asciidoc einbinden können. Nachteil: Wenn man mal schnell etwas ändern möchte, kann man keine bunten Boxen hin- und herschieben. Das geht aber zum Beispiel mit Draw.io, für das es auch ein VSCode-Plugin gibt. Man legt einfach eine Datei mit Endung .drawio.svg an, Draw.io gibt uns dafür eine schicke GUI und schreibt im Hintergrund SVG – streng genommen auch “as Code”, wenn man so will.
Interaktive Dokumentation mit Jupyter-Notebooks
In unserem Projekt hat sich zusätzlich die Verwendung von Jupyter-Notebooks sowohl zum Experimentieren als auch zur Dokumentation der dadurch gewonnen Erkenntnisse sehr bewährt. Jupyter-Notebooks sind JSON-Dateien, die von der IDE als Entwicklungswerkzeug dargestellt werden. In den Notebooks kann interaktiv in einzelnen Zellen Code ausgeführt und Markdown gerendert werden. Viel näher am Code kann man kaum dokumentieren. Die damit erzeugte Dokumentation ist interaktiv und damit sehr anschaulich, da Konzepte und Erkenntnisse direkt nachvollzogen und selbst ausprobiert werden können.
Docs-as-Code als das Allheilmittel für den Informationsaustausch
Seit wir Docs-as-Code verwenden, gibt es keine Kommunikationsprobleme mehr im Projektkontext. Selbst wenn Mitwirkende das Projekt verlassen, gehen keine Informationen mehr verloren, da jeder weiß, wo welche Information zu finden ist.
Das ist natürlich glatt gelogen.
Ziel dieses Artikels ist es nicht, Docs-as-Code als etwas darzustellen, das es nicht ist. Solange noch menschliche Autoren ihre tippfreudigen Finger im Spiel haben, sind Fehler und Missverständnisse natürlich nicht ausgeschlossen. Letztendlich liegt es weiterhin in der Verantwortung jedes Einzelnen (und bei richtiger Anwendung auch in der Verantwortung eines zweiten Paares Augen), dafür zu sorgen, dass die Dokumentation den selbst gesetzten Standards entspricht. Das wird durch den Einsatz von KI auch nicht besser. Obwohl alle XasCode-Ansätze sehr LLM-freundlich sind, sollte vor allem eine schnell mal eben generierte Dokumentation aufmerksam gereviewt werden. Denn unsere maschinellen Helfer haben von den Besten gelernt, wenn es um schlechte Dokumentation geht, und erfinden zusätzlich auch gerne neue Fakten.
Viel wertvoller als jede technische Hilfestellung ist beim Dokumentieren meiner Meinung nach das richtige Mindset. Herr Peter Naur (ja, das ist der aus Backus-Naur) betrachtet Programmieren als den Aufbau einer Theorie über das Problem und dessen Lösungsumsetzung. Der Programmcode ist dabei nur eines der Artefakte, die dabei entstehen. Er hat erkannt, dass selbst die beste Dokumentation die im Kopf des ursprünglichen Entwicklers entstandene Theorie nicht vollständig transportieren kann. Um ein komplexes System tatsächlich zu verstehen, sind daher Erfahrung und ein gutes Verständnis des Codes entscheidend. Interessanterweise wird genau an dieser Stelle die Verbindung zu dem Begriff „Clean Code“ gezogen: Auch der Code selbst sollte es der nächsten Entwicklerin bzw. dem nächsten Entwickler ermöglichen, eine möglichst kohärente Theorie des Systems aufzubauen.
Wir sind also offensichtlich noch nicht am Ende unserer Reise angekommen, wenn wir wissen wollen, wie wir als Autor*innen unsere Ideen so nachvollziehbar wie möglich festhalten können. Wir von pentacor haben noch ein paar Tricks auf Lager, mit denen wir auch unseren Code cleaner machen – und das, wer hätte das geahnt, mit weiteren XasCode-Kniffen. Aber dazu später mehr.