76 Prozent. So sicher war sich ein Sprachmodell laut seiner eigenen Konfidenz-Metrik bei der Frage: Wie ist das Wetter in Stockholm? Auf aktuelle Daten habe es keinen Zugriff, antwortete es, aber üblicherweise sei es zu dieser Jahreszeit kühl und regnerisch. Tatsächlich war es an diesem Tag sonnig und warm. Die hohe Konfidenz galt der ganzen Antwort - nicht der Tatsache, dass es sich nur um eine typische Einschätzung handelte, keine echte Vorhersage für diesen Tag. Und trotzdem war sich das Modell zu 76 Prozent sicher.
Das ist der Punkt. Nicht, dass das Modell falsch lag, sondern dass es nicht wusste, wie falsch es lag. Im Forschungsprojekt GENIUS haben wir genau das systematisch untersucht: Wir haben Modelle befragt, Konfidenz-Metriken ausgelesen, Antworten fachlich bewertet. Das Ergebnis war immer ähnlich: Die Werte lagen fast immer über 70 Prozent – unabhängig davon, ob die Antwort stimmte und faktisch geprüft werden konnte. Die Selbsteinschätzung des Modells war also kaum ein verlässlicher Indikator für die tatsächliche Qualität der Antwort. Sprachmodelle sind darauf trainiert, plausibel zu klingen. Ob sie tatsächlich etwas nicht wissen, merken sie selbst kaum – Selbstzweifel sind einfach nicht ihr Ding.
Also haben wir uns selbst gefragt: Wie confident bist du eigentlich? Und entschieden, die Antwort nicht dem Modell zu überlassen.
Strukturiertes Wissen statt Sprachgefühl
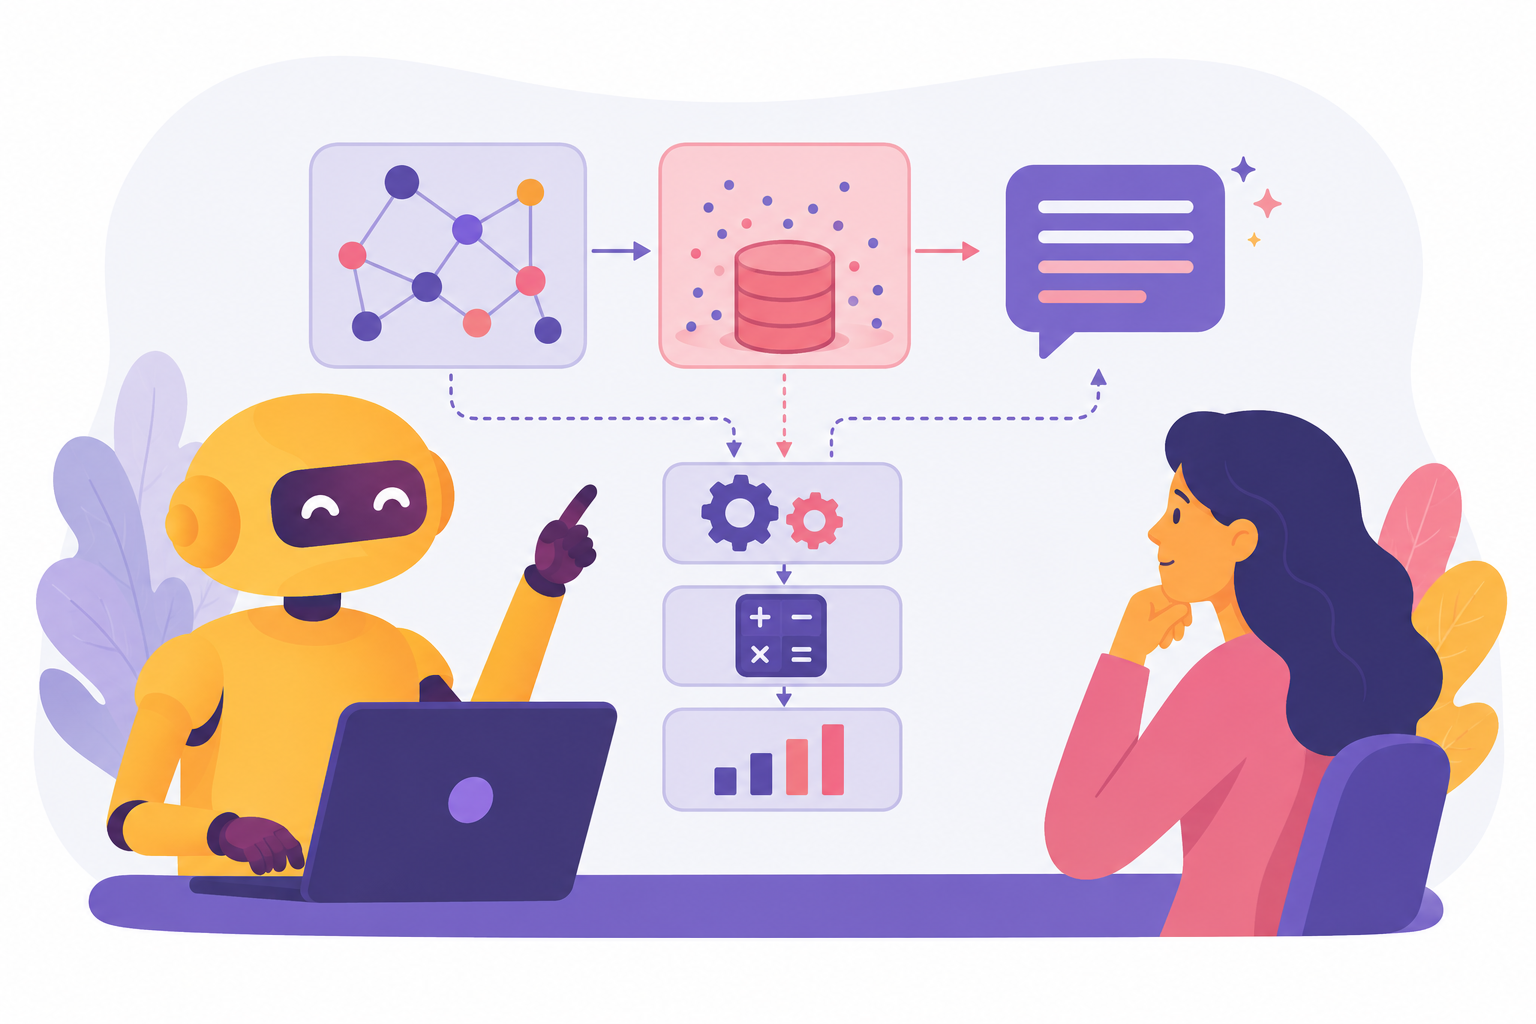
Der Ansatz, den wir in GENIUS verfolgen, heißt Neurosymbolic AI. Die Idee ist im Kern einfach: Was wir wissen und fachlich validiert haben, speichern wir strukturiert in einem RDF-Wissensgraphen. Dort liegen eindeutige Fakten, Konzepte und ihre Beziehungen zueinander. Ergänzt wird er durch eine Vektordatenbank, mit der sich auch Inhalte finden lassen, die nicht exakt, aber semantisch zu einer Anfrage passen.
Das Sprachmodell nutzt diese Wissensgrundlage, um Antworten zu formulieren und Informationen miteinander zu verknüpfen. Fehlendes Wissen soll es dabei nicht einfach selbst ergänzen.
GENIUS soll dabei zwei Dinge gleichzeitig können: vorhandenes Expertenwissen abrufbar machen und neues Expertenwissen strukturiert aufnehmen. Beides ist wichtig: Eine Wissensbasis, die nicht wächst, veraltet.
Bei Fabrikplanung, Ökobilanzierung in der Produktion oder dem Digitalen Produktpass ist das kein akademischer Unterschied. Ein System, das selbstsicher das falsche Wartungsintervall nennt, ist schlechter als keines.
Ein System, das sich selbst hinterfragt
Wir entwerfen und evaluieren gerade einen LangGraph-basierten Agenten mit zwei Pfaden: einem Lesepfad für Anfragen und einem Schreibpfad für die Pflege des Wissens. Beide hängen enger zusammen, als man zunächst denkt.
Im Schreibpfad wird neues Expertenwissen nicht einfach übernommen. Jeder neue Inhalt durchläuft eine Ontologiebewertung: Passt das neue Wissen zur bestehenden Struktur? Gibt es Widersprüche? Sind neue Konzepte nötig, die die Ontologie selbst erweitern? Und vor jedem Eintrag in die Wissensbasis steht immer ein Mensch, der explizit zustimmt. Dieses Human-in-the-Loop-Prinzip beim Schreiben ist kein Sicherheitsnetz für den Notfall, sondern Teil des Designs. Denn die Qualität des Schreibpfads bestimmt direkt die Qualität des Lesepfads.
Im Lesepfad kontrolliert sich das System selbst in mehreren Stufen:
- Die Anfrage wird in eine strukturierte Datenbankabfrage und eine semantische Suchanfrage zerlegt.
- Eine interne Klassifikation leitet die Anfrage in den richtigen Wissensbereich: Fabrikplanung, Verbesserung ökobilanzieller Prozesse in der Produktion oder Digitaler Produktpass.
- Eine interne Prüfstufe bewertet, ob die gefundenen Inhalte tatsächlich zur Anfrage passen: strukturell korrekt im Sinne der Ontologie, nicht bloß thematisch in der Nähe. Reicht das nicht, springt das System bis zu zweimal zurück in die Suche – mit einer Diagnose, was genau gefehlt hat.
- Erst, wenn diese Prüfung bestanden ist, wird eine Antwort generiert – und danach noch einmal gegen Quellen und Fachregeln geprüft.
Auch im Lesepfad ist an einer Stelle ein Mensch vorgesehen. Reicht die Evidenz gar nicht aus, lehnt das System die Antwort ab. Reicht sie nur teilweise, übernimmt ein Mensch die Prüfung. Ist sie dagegen ausreichend, wird die Antwort direkt ausgegeben.
Konfidenz, die man nachrechnen kann
Das Herzstück des Ansatzes ist ein finaler Confidence Score. Nicht das, was das Modell über sich selbst denkt – sondern das, was wir von außen nachrechnen können. Er setzt sich aus drei unabhängigen Teilscores zusammen, die jeweils eine andere Frage beantworten.
Retrieval-Qualität: Hat die Wissensbasis zur Anfrage gepasst?
Bevor überhaupt eine Antwort generiert wird, prüfen wir, wie gut die gefundenen Inhalte zur Anfrage passen. Dabei zählen drei Dinge: Wie vollständig hat der Wissensgraph die relevanten Konzepte abgedeckt? Wie ähnlich waren die gefundenen Dokumente inhaltlich? Und wie vertrauenswürdig sind die Quellen – manuell geprüft, automatisch validiert oder einfach nur extrahiert? Strukturierte Fakten aus dem Wissensgraphen zählen dabei stärker als semantische Ähnlichkeit aus der Vektordatenbank, weil sie verlässlicher sind. Reicht dieser Wert nicht aus, wird nicht einfach weitergemacht: Das System versucht bis zu zweimal, mit einer Diagnose der Lücke erneut zu suchen. Faithfulness- und Domain-Check laufen erst danach – nie auf einer Wissensgrundlage, die diese Prüfung nicht bestanden hat.
Faithfulness: Ist jede Aussage der Antwort durch die Quellen gedeckt?
Dieser Score ist der gewichtigste der drei, weil er am direktesten misst, ob das Sprachmodell halluziniert. Die generierte Antwort wird dafür in einzelne Behauptungen zerlegt und jede davon separat gegen die Quell-Inhalte geprüft. Nicht die Antwort als Ganzes, sondern Aussage für Aussage. Eine Antwort kann zu 80 Prozent korrekt sein und trotzdem eine erfundene Behauptung enthalten – genau das soll der Score zeigen.
Domain Validity: Verletzt die Antwort Fachregeln?
Manche Fehler sind keine Frage der Quellenlage, sondern der Fachlogik. Dieser Score prüft die Antwort gegen domänenspezifische Regeln – zum Beispiel Normen, Gesetze oder technische Constraints des jeweiligen Bereichs. Wird eine solche Regel verletzt, kappen wir den Score nach unten – ganz unabhängig davon, wie gut die anderen Teilscores sind.
Die drei Teilscores werden bewusst nicht einfach gemittelt. Ein schwacher Wert zieht das Gesamtergebnis spürbar nach unten. Denn ein guter Wert in einer Dimension darf einen kritischen Fehler in einer anderen nicht ausgleichen. Fachlich korrekt, aber halluzinierend? Dafür gibt's keinen hohen Gesamtscore.
Was der Score bedeuten soll
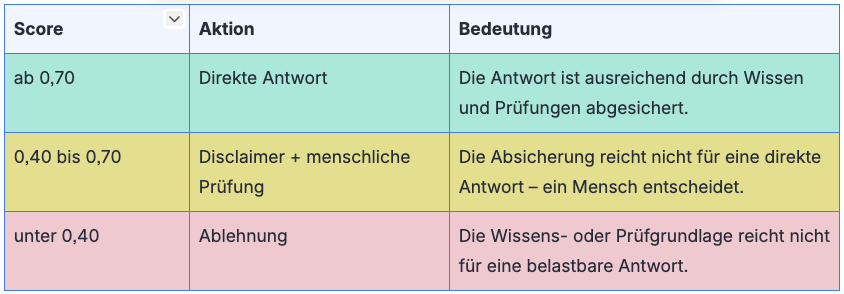
Die Werte orientieren sich an gängigen Schwellen aus der Literatur zu RAG- und Confidence-Scoring-Systemen – sie sind aber keine für unseren Anwendungsfall empirisch hergeleiteten festen Grenzen. Ob diese Schwellenwerte so stimmen, ist eine der zentralen Fragen unserer Evaluation. Genau dafür benötigen wir reale Szenarien.
Von der Forschung in die Praxis
Viele KI-Projekte scheitern nicht an der Technologie, sondern am Vertrauen. Entweder vertraut man dem System blind – und bereut es. Oder man vertraut ihm gar nicht – und lässt es gleich liegen.
Was wir in GENIUS entwickeln, zielt auf etwas anderes: Wir wollen verstehen, was es braucht, damit man einem KI-System begründet vertrauen kann. Systeme, die zeigen, woher eine Antwort kommt. Die wissen, wann sie sich sicher sind. Und die einen Menschen genau dann einbinden, wenn es zählt.
Diese Fragen evaluieren wir bei pentacor an realen Szenarien aus den drei genannten Bereichen. Was wir dabei lernen, soll in unsere Kundenprojekte einfließen.
Denn die Frage "Wie confident bist du eigentlich?" stellt sich nicht nur in der Forschung. Sie stellt sich bei jedem produktiven KI-System, dessen Antworten echte Entscheidungen beeinflussen. Nur sollte man die Antwort darauf vielleicht nicht der KI selbst überlassen.
76 Prozent allein reichen uns nicht mehr – wir arbeiten an einer Antwort, die nicht behauptet, sondern belegt, wie sicher sie sich sein darf.